重點整理
AI 爬蟲依用途分成三種:搜尋用(例如 OAI-SearchBot、Claude-SearchBot、PerplexityBot)、使用者觸發(例如 ChatGPT-User、Claude-User)、模型訓練用(例如 GPTBot、ClaudeBot)。想被 ChatGPT、Claude、Perplexity 引用,robots.txt 至少要開放搜尋用的爬蟲;擋掉訓練用爬蟲不影響被引用。設定完成後,再檢查 Cloudflare 等防火牆有沒有另外擋,並從主機日誌確認爬蟲真的讀得到網站。
在 AI SEO 入門裡提到,讓 AI 讀得到網站是第一步。但打開 robots.txt 時,很多人會被一長串陌生的名稱考倒:GPTBot 和 OAI-SearchBot 差在哪?ClaudeBot 擋了會怎樣?Google-Extended 又是什麼?這篇把 2026 年主要的 AI 爬蟲整理成一張表,說明三種常見的 robots.txt 寫法,最後用鵠學苑自己的主機日誌示範,怎麼確認 AI 爬蟲真的有來讀網站。
AI 爬蟲有哪三種?差別在哪?
同一家 AI 公司通常有好幾個爬蟲,各自負責不同工作。判斷要不要開放之前,先分清楚它們的用途:
- 搜尋用:平常就在網路上建立索引,使用者提問時,AI 從這份索引找資料並標示來源。擋掉它,就不會出現在該 AI 的搜尋答案裡。
- 使用者觸發:使用者在對話中貼網址、或要求 AI 上網查資料時,才即時去讀那一頁。它不會自動到處爬,部分業者也說明這類請求不一定遵守 robots.txt。
- 模型訓練用:收集公開網頁當作訓練資料。擋掉它,代表不希望內容被拿去訓練未來的模型,但不影響目前是否被引用。
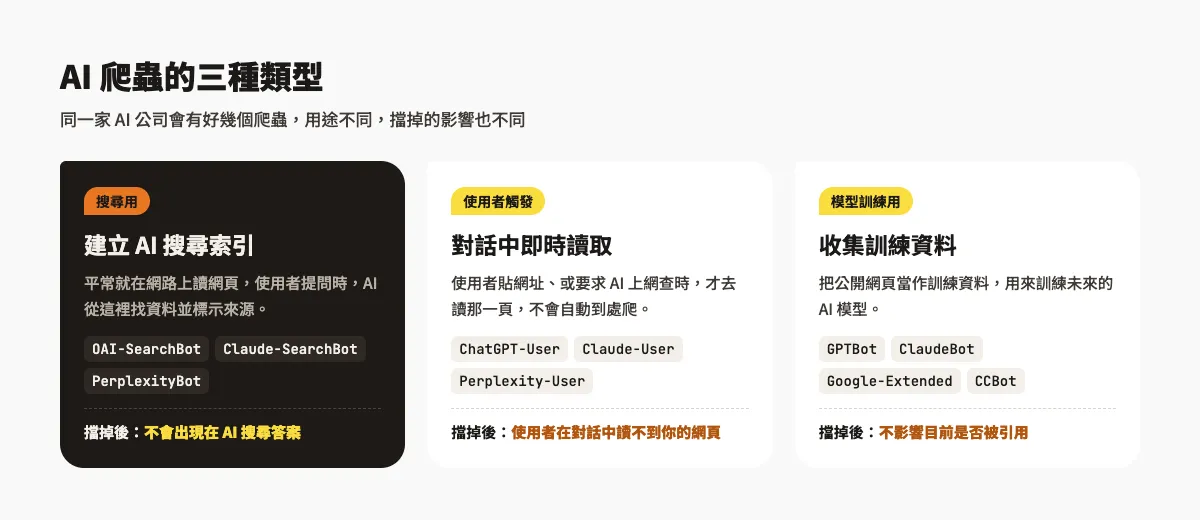
上圖是這三種爬蟲的對照。實務上最常見的誤會,是把「擋 AI」理解成全部擋掉,結果連搜尋用的爬蟲一起擋,網站就從 ChatGPT 搜尋與 Perplexity 的答案裡消失了。
2026 年主要 AI 爬蟲名單
下表依各家官方文件整理,左欄就是寫在 robots.txt User-agent: 後面的名稱(大小寫照官方寫法):
| AI 服務 | 搜尋用 | 使用者觸發 | 訓練用 |
|---|---|---|---|
| ChatGPT | OAI-SearchBot | ChatGPT-User | GPTBot |
| Claude | Claude-SearchBot | Claude-User | ClaudeBot |
| Perplexity | PerplexityBot | Perplexity-User | — |
| Gemini | Googlebot | — | Google-Extended |
| Apple | Applebot | — | Applebot-Extended |
| Copilot | bingbot | — | — |
表中 ChatGPT 屬於 OpenAI、Claude 屬於 Anthropic;Perplexity 官方表示它的爬蟲不用於訓練模型。另外常在日誌裡看到的還有 DuckDuckGo 的 DuckAssistBot(AI 回答用),以及 Common Crawl 的 CCBot、Meta 的 meta-externalagent、字節跳動的 Bytespider,後三者主要用於收集訓練資料。
有兩個地方特別容易搞錯:
- Google-Extended 與 Applebot-Extended 不是真的爬蟲。它們只是寫在 robots.txt 裡的「控制用名稱」,實際來抓網頁的仍是 Googlebot 和 Applebot。擋 Google-Extended 代表不讓內容被拿去訓練 Gemini 與用在 Gemini 的回答,不會讓網站從 Google 搜尋或 AI 摘要消失。
- Copilot 與 Google AI 摘要沒有專屬的 AI 爬蟲。Copilot 使用 Bing 的索引,Google AI 摘要與 AI 模式使用一般的 Googlebot。只要 Bing 與 Google 收錄正常,這兩個就不需要另外開放。
AI 公司偶爾會新增或改名爬蟲,例如 Anthropic 早期使用的 anthropic-ai 已由 ClaudeBot 取代。設定前建議到各家官方說明頁再確認一次:OpenAI、Anthropic、Perplexity。
robots.txt 要怎麼寫?三種常見做法
robots.txt 的基本語法與上傳方式,可以參考 robots.txt 設定教學。針對 AI 爬蟲,依網站的立場可以分成三種寫法:
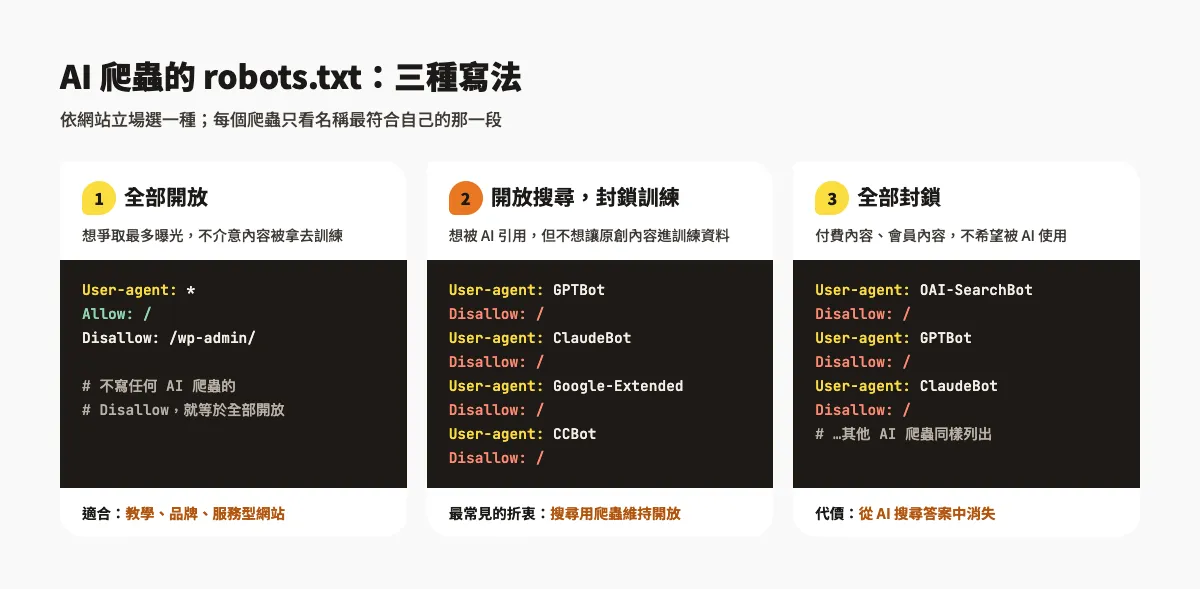
做法一:全部開放(適合想爭取曝光的網站)
robots.txt 的 User-agent: * 沒有 Disallow: /,就代表所有爬蟲都能讀。想讓意圖更明確,也可以把 AI 爬蟲一個一個列出來寫 Allow: /。鵠學苑目前就是這個做法:教學內容本來就希望被更多人看到,被拿去訓練也能讓 AI 回答時更熟悉這些主題。
做法二:開放搜尋,封鎖訓練(最常見的折衷)
想被 AI 引用、又不希望原創內容被拿去訓練模型,就只擋訓練用的名稱:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: CCBot
Disallow: /
OAI-SearchBot、Claude-SearchBot、PerplexityBot 沒有被列出,就會套用 User-agent: * 的規則,維持可以讀取。要注意每個爬蟲只看「名稱最符合自己」的那一段,所以不要把 Disallow: / 寫在 User-agent: * 底下,否則所有沒被單獨列出的爬蟲都會被擋。
做法三:全部封鎖(付費內容或不希望被 AI 使用的網站)
把三種爬蟲都列出來寫 Disallow: /。要有心理準備:網站會從 ChatGPT 搜尋、Claude、Perplexity 的答案中消失。另外,使用者觸發類的爬蟲不一定遵守 robots.txt,真的要完全阻擋,需要在防火牆另外設定。
步驟一:打開自己的 robots.txt 檢查
在瀏覽器網址列輸入「你的網址/robots.txt」,逐段確認:
User-agent: *底下沒有Disallow: /(這行代表擋掉全站)。- 搜尋用的 AI 爬蟲名稱底下沒有
Disallow: /。 - 如果是 WordPress 網站,確認「設定 → 閱讀」的「搜尋引擎可見度」沒有勾選,否則網站會對所有搜尋引擎送出不要收錄的訊號。
改完 robots.txt 不會立刻生效。OpenAI 與 Perplexity 都說明系統大約需要 24 小時才會套用新的規則。
步驟二:檢查 Cloudflare 與主機防火牆有沒有另外擋
robots.txt 寫了開放,不代表爬蟲一定進得來。越來越多網站把 AI 爬蟲擋在防火牆這一層,網站管理者自己卻不知道:
- Cloudflare:2025 年 7 月起,新加入的網域預設會封鎖已知的 AI 爬蟲;2026 年又把 AI 爬蟲細分為搜尋、代理、訓練三類,可以分別設定允許或封鎖。用 Cloudflare 的網站,請到後台的 AI 爬蟲控制(AI Crawl Control)頁面確認搜尋類爬蟲是允許的。
- 主機與資安外掛:主機商的防火牆、Wordfence 等資安外掛,可能把短時間大量讀取的爬蟲當成攻擊而封鎖。遇到這種情況,可以把 AI 搜尋爬蟲加入允許名單,或請主機商協助確認。
步驟三:從主機日誌確認 AI 爬蟲真的有來
最準確的檢查方式是看網站主機的存取日誌(access log)。每一筆紀錄都會記下來訪者的名稱(User-Agent)與回應狀態碼,用爬蟲名稱搜尋,就知道它多久來一次、有沒有讀到內容。下面是鵠學苑 2026 年 10 月 3 日到 13 日,共 11 天的統計:
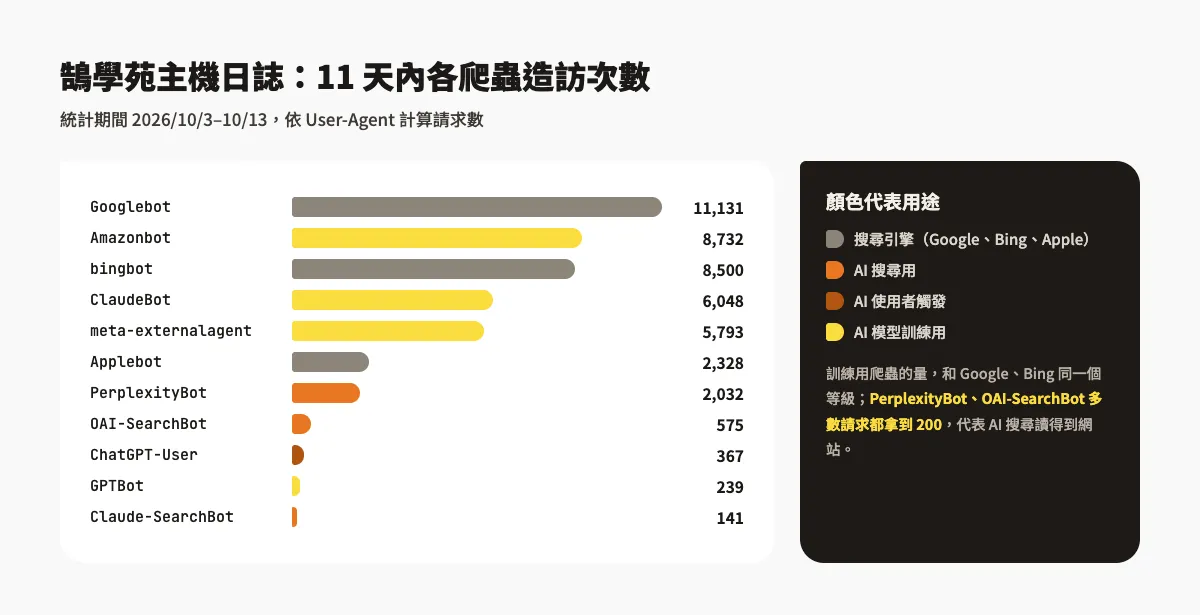
從這份數字可以看出幾件事:
- 訓練用的 ClaudeBot、meta-externalagent,造訪次數與 Googlebot、bingbot 同一個量級,是 AI 爬蟲中最勤快的。
- 搜尋用的 PerplexityBot 約 2,000 次、OAI-SearchBot 約 580 次,而且多數請求都拿到 200(成功讀到網頁),代表 AI 搜尋讀得到網站。
- 使用者觸發的 ChatGPT-User 有 367 次,代表確實有人在 ChatGPT 裡讓 AI 即時來讀鵠學苑的文章。
- 被 robots.txt 封鎖的 Bytespider,在主機防火牆也被擋下,回應都是 403。
如果使用 RunCloud、cPanel 等主機管理介面,通常可以直接下載日誌;有 SSH 權限的話,可以用一行指令統計某個爬蟲的次數,例如:
grep -c "OAI-SearchBot" access.log沒有主機日誌可看的網站,也可以從 Cloudflare 的 AI 爬蟲控制頁面看各家爬蟲的請求數。
日誌裡的 AI 爬蟲一定是真的嗎?
不一定。User-Agent 只是一段文字,任何人都能冒用。鵠學苑的日誌裡,就有一批自稱 Claude-User、Perplexity-User 的請求,專門去試 .env 這類不存在的檔案,回應幾乎都是 404 或 403,看起來是冒名的掃描程式,而不是真正的 AI。要確認真偽,可以比對官方公布的 IP 範圍:OpenAI 為每個爬蟲公布了 IP 清單(例如 OAI-SearchBot 的 openai.com/searchbot.json),Googlebot 與 bingbot 則可以用反查 DNS 確認網域是否屬於 Google 或 Microsoft。
常見問題
擋掉 GPTBot,ChatGPT 還會引用我的網站嗎?
會。ChatGPT 搜尋與引用使用的是 OAI-SearchBot,GPTBot 只負責收集訓練資料。OpenAI 官方說明兩者的設定互相獨立,可以開放 OAI-SearchBot、封鎖 GPTBot。
擋 Google-Extended 會讓網站從 Google AI 摘要消失嗎?
不會。Google AI 摘要使用一般的 Googlebot 讀取網頁,Google-Extended 只控制內容能否用於訓練 Gemini 與 Gemini 的回答。想限制 AI 摘要顯示的內容,要用 nosnippet、max-snippet 等搜尋結果的控制方式。
robots.txt 開放了,為什麼日誌裡看不到 AI 爬蟲?
最常見的原因是被防火牆擋下,請先檢查 Cloudflare 的 AI 爬蟲設定與主機的資安規則。另外,新網站或很少更新的網站,AI 爬蟲來訪的頻率本來就比較低,可以先確認 Google 與 Bing 收錄正常,再持續觀察。
結語
AI 爬蟲的設定,關鍵在分清楚搜尋、使用者觸發、模型訓練三種用途:想被 AI 引用,就一定要開放搜尋用的爬蟲;訓練用的要不要擋,依網站的立場決定,不影響被引用。改完 robots.txt 之後,記得檢查 Cloudflare 與防火牆,最後用主機日誌確認爬蟲真的讀得到網站,這一步做完,才算真正把門打開。